Moteur de recherche : définition simple et comment Google explore, indexe et classe votre site
G. CHRIST
Publié le 19 octobre 2026
« Notre site est en ligne depuis deux mois, mais quand on tape notre nom sur Google, rien. » C'est une des phrases que nous entendons le plus souvent quand une PME, une ONG ou un service public nous contacte. Le plus souvent, le problème n'a rien de mystérieux. Il se situe à une étape précise du travail d'un moteur de recherche, et on peut la vérifier en quelques minutes à condition de savoir comment la machine fonctionne.
C'est l'objet de cet article. Je pose d'abord une définition propre du moteur de recherche, avec des exemples et les chiffres d'usage au Bénin. Ensuite, j'ouvre le capot : comment Google découvre une page, la lit, la range dans son index, puis décide de l'afficher ou non. Pour chaque étape, je vous indique ce qui casse le plus souvent sur les sites que nous auditons, et le contrôle à faire. Si vous cherchez plutôt la marche à suivre pour faire apparaître votre site (Search Console, sitemap, premières actions), elle est détaillée dans notre guide Comment apparaître sur Google. Ici, on parle du mécanisme.
Définition d'un moteur de recherche
Un moteur de recherche est un service en ligne qui parcourt automatiquement le Web, enregistre ce qu'il trouve dans une immense base de données, puis, quand vous tapez quelques mots, vous renvoie en une fraction de seconde la liste des pages qui y répondent le mieux. Google, Bing, Yahoo!, DuckDuckGo, Ecosia ou Qwant sont des moteurs de recherche.
La définition officielle française, publiée au Journal officiel du 1er septembre 2000, est plus austère : un « système d'exploitation de banque de données, et, par extension, serveur spécialisé permettant d'accéder sur la toile à des ressources (pages, sites, etc.) à partir de mots clés » (FranceTerme). Elle a le mérite de rappeler l'essentiel : un moteur ne cherche pas sur Internet au moment où vous tapez votre requête. Il cherche dans sa propre base, constituée à l'avance.
Tout moteur de recherche repose sur trois briques :
- un robot d'exploration (on dit aussi crawler, spider ou bot), un programme qui visite les pages et suit les liens ;
- un index, la base de données où le contenu des pages est analysé et rangé, un peu comme l'index à la fin d'un livre ;
- un algorithme de classement, qui décide, pour chaque recherche, quelles pages montrer et dans quel ordre.
Le glossaire de Mozilla résume la même chose avec trois processus : le robot d'indexation, l'indexation et la recherche (MDN, Moteur de recherche).
Logos officiels de Google et de Google Search Console (marques de Google LLC), récupérés depuis les sites de Google.
Et « moteur de recherche » en informatique, au sens large ?
Le terme désigne aussi la petite barre de recherche intégrée à un site (chercher un produit dans une boutique en ligne), à une messagerie ou à Windows. Le principe est identique, à une échelle réduite : on indexe un ensemble de documents à l'avance, puis on les interroge. Dans la suite de l'article, je parle des moteurs du Web, et surtout de Google.
Moteur de recherche, navigateur, site : trois choses différentes
La confusion est très répandue, y compris chez des responsables de communication. Chrome, Firefox, Safari ou Opera sont des navigateurs : des logiciels qui affichent les pages web. Google est un moteur de recherche : un service qui vous aide à trouver ces pages. guelichweb.online est un site : un ensemble de pages publiées à une adresse. Quand vous ouvrez Chrome et que vous tapez une question dans la barre d'adresse, Chrome transmet la question au moteur réglé par défaut, souvent Google. Ce n'est pas Chrome qui cherche.
Nous avons détaillé cette différence, avec des exemples, dans notre article Navigateur web : définition et lequel choisir. Pour l'adresse elle-même, voyez URL : définition et ce que veut dire chaque partie.
Exemples de moteurs de recherche, et ceux qu'on utilise vraiment au Bénin
Il existe des dizaines de moteurs, mais leur poids réel n'a rien à voir. D'après StatCounter, qui mesure les visites sur un large panel de sites, voici les parts de marché des moteurs de recherche en septembre 2026, tous appareils confondus :
- Bénin : Google 95,11 %, Bing 4,16 %, Yahoo! 0,25 %, DuckDuckGo 0,16 %, Yandex 0,14 % (StatCounter, Bénin).
- Afrique : Google 95,66 %, Bing 3,58 %, Yahoo! 0,26 % (StatCounter, Afrique).
- France : Google 88,16 %, Bing 5,47 %, Yahoo! 2,75 %, Ecosia 1,34 %, Qwant 0,86 % (StatCounter, France).
- Monde : Google 89,94 %, Bing 5,29 %, Yahoo! 1,36 % (StatCounter, monde).
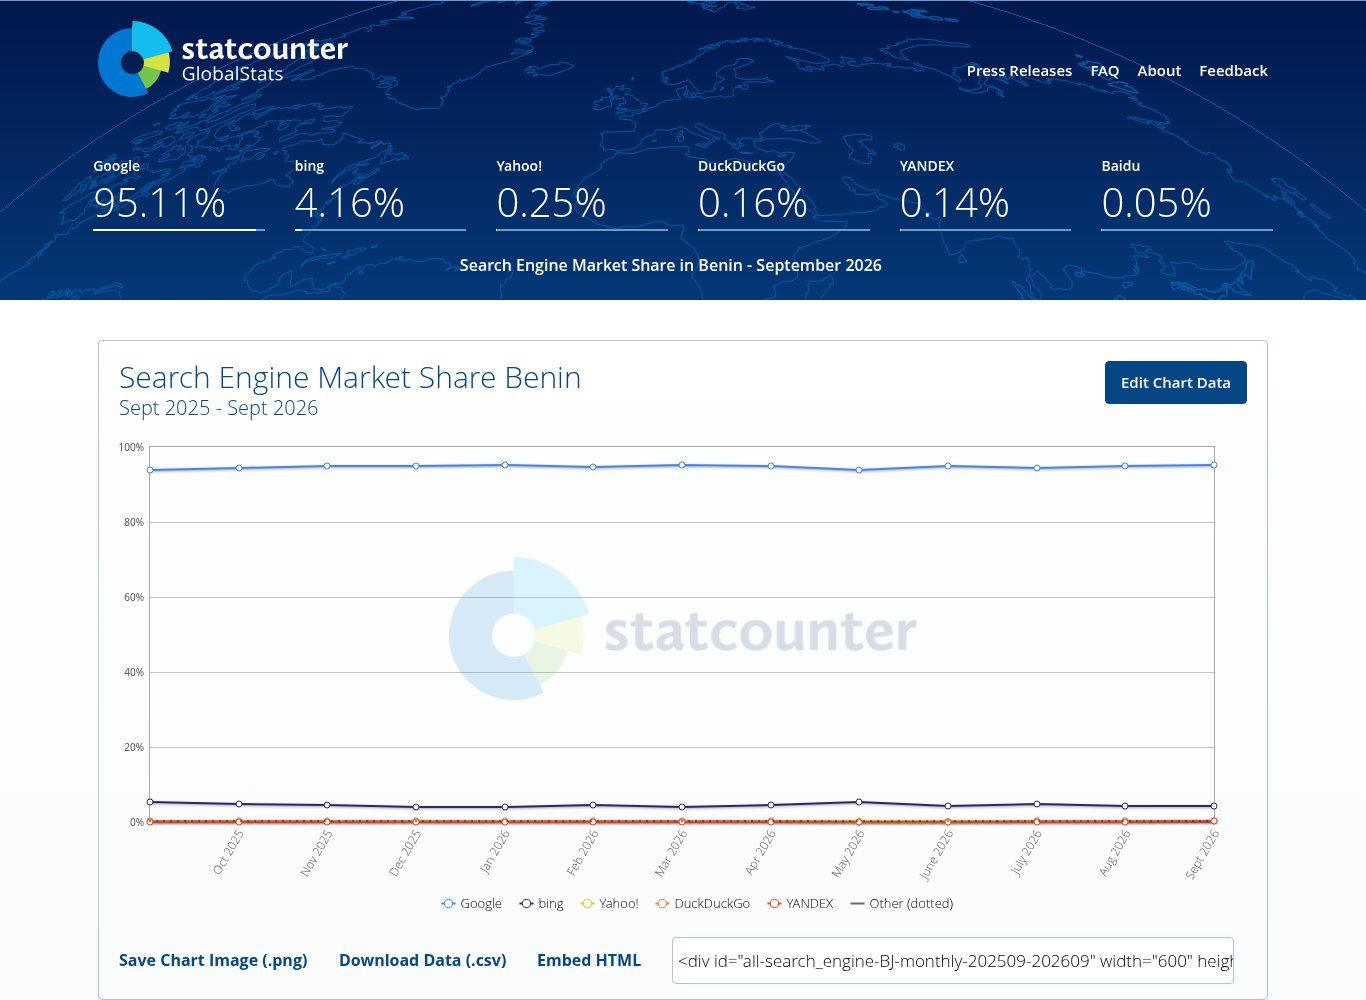
Source : StatCounter Global Stats, parts de marché des moteurs de recherche au Bénin, capture du 19/10/2026.
Notre lecture est simple : pour une entreprise ou une organisation au Bénin, travailler sa visibilité, c'est d'abord travailler sa présence sur Google. Cela ne veut pas dire ignorer Bing : il pèse davantage en France et dans le monde, et déclarer son site dans Bing Webmaster Tools prend dix minutes. Mais si vous n'avez qu'une demi-journée à y consacrer, elle va à Google.
Les grands types de moteurs
- Les moteurs à robots (Google, Bing, Yandex, Baidu) : ils explorent eux-mêmes le Web et construisent leur propre index. C'est le modèle dominant.
- Les moteurs qui s'appuient sur l'index d'un autre ou sur plusieurs sources (on parle parfois de méta-moteurs) : l'interface est différente, mais une partie des résultats vient d'ailleurs.
- Les annuaires, ancêtres des moteurs : des humains classaient les sites par catégories. Cette méthode a atteint ses limites avec l'explosion du Web.
- Les moteurs de recherche avec IA : ils rédigent une réponse à partir de pages trouvées en ligne, avec des liens vers leurs sources. Google le fait lui-même avec les Aperçus IA et le Mode IA (j'y reviens plus bas).
- Les moteurs internes et spécialisés : recherche d'un site, moteurs scientifiques, moteurs d'images ou de vidéos comme YouTube.
Comment s'appelle le processus qu'utilisent les moteurs de recherche ?
C'est une question que beaucoup de gens tapent mot pour mot, souvent pour un devoir ou un test de compétences numériques. La réponse dépend de ce que l'on désigne :
- le processus par lequel un moteur parcourt le Web en suivant les liens s'appelle l'exploration, en anglais crawling. Il est réalisé par des robots d'exploration ;
- le processus par lequel il analyse et range le contenu des pages dans sa base s'appelle l'indexation ;
- le processus par lequel il ordonne les résultats pour une requête s'appelle le classement, en anglais ranking.
La CNIL présente exactement ces trois étapes, exploration, indexation, classement (CNIL, Moteurs de recherche : comment ça fonctionne ?). Google, de son côté, parle d'exploration, d'indexation et de diffusion des résultats (Google Search Central). Si l'on vous demande un seul mot pour « le processus qui consiste à parcourir le Web avec des robots », c'est exploration (crawling). Si l'on parle de référencer les pages dans la base, c'est indexation.
En pratique, Google ajoute une étape entre les deux premières, qu'on oublie souvent et qui fait perdre beaucoup de visibilité : le rendu. Voici le parcours complet.
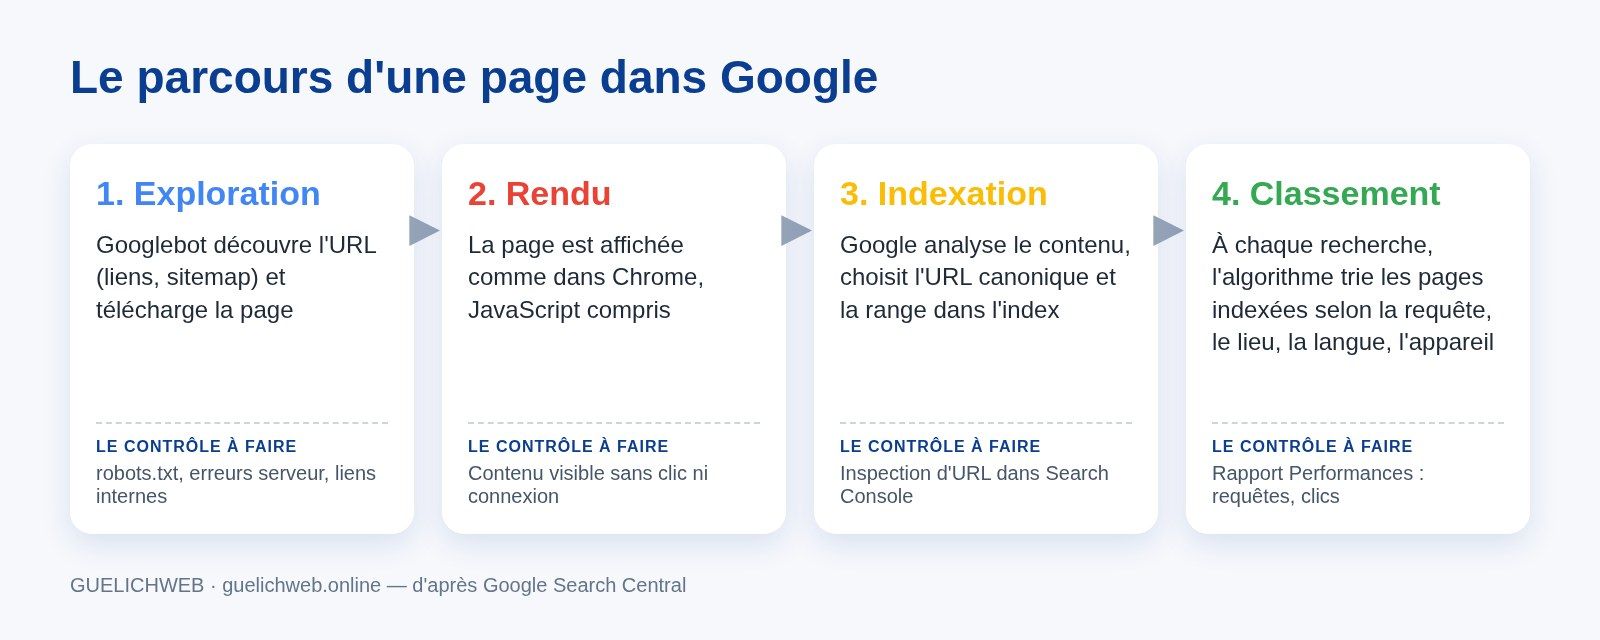
Schéma Guelichweb d'après la documentation Google Search Central : les étapes que traverse une page, et le contrôle à faire à chacune.
Étape 1 : l'exploration (crawling)
Il n'existe aucun registre central des pages du Web. Google doit donc découvrir les adresses par lui-même : c'est ce qu'il appelle la « détection d'URL ». Il trouve une nouvelle page principalement en suivant un lien depuis une page qu'il connaît déjà, ou parce que le propriétaire du site lui a fourni une liste d'adresses, le sitemap (Google, Guide détaillé de la recherche).
Le programme qui fait ce travail s'appelle Googlebot. Il en existe deux versions, smartphone et ordinateur, et pour la plupart des sites Google indexe principalement la version mobile du contenu (Google, Présentation de Googlebot). Autrement dit, si votre site est correct sur ordinateur mais tronqué sur téléphone, c'est la version tronquée que Google retient. Au Bénin, où le mobile représentait environ 60 % des visites web en septembre 2026 (StatCounter, plateformes au Bénin), c'est une double peine.
Source : Google Search Central, « Guide détaillé de la recherche Google » (developers.google.com), capture du 19/10/2026.
Quelques précisions officielles qui ont des conséquences très concrètes :
- Googlebot ne lit pas des fichiers infinis. Selon la documentation consultée le 19/10/2026, il explore les 2 premiers Mo d'un fichier HTML ou d'un autre type compatible, et les 64 premiers Mo d'un PDF. Ce qui dépasse n'est pas pris en compte.
- Il ralentit quand votre serveur souffre. Les erreurs serveur (de type 500) sont interprétées comme un signal de ralentissement. Un hébergement saturé ou souvent en panne réduit donc mécaniquement l'exploration.
- Il ne voit pas ce qui est derrière une connexion. Une page réservée aux membres ou un espace client n'est pas exploré.
- Il respecte le fichier robots.txt, placé à la racine du site, qui indique les zones à ne pas explorer.
Ce qui bloque l'exploration sur les sites que nous auditons
- Une page qui n'est reliée à rien : elle existe, mais aucun menu, aucun article et aucun autre site ne pointe vers elle. On l'envoie par WhatsApp, et Google ne la trouve jamais.
- Un hébergement d'entrée de gamme qui coupe régulièrement ou répond en plusieurs secondes.
- Un fichier robots.txt resté en mode « tout bloquer » après la phase de développement.
- Un site entier caché derrière une page « en construction » ou un mode maintenance oublié.
Le contrôle à faire : ouvrez votre-site.com/robots.txt dans le navigateur et vérifiez qu'il ne contient pas une ligne « Disallow: / » sous « User-agent: * ». Puis assurez-vous que chaque page importante est accessible en deux ou trois clics depuis l'accueil.
Étape 2 : le rendu, l'étape que tout le monde oublie
Une fois la page téléchargée, Google l'affiche comme le ferait votre navigateur, en exécutant le JavaScript avec une version récente de Chrome. Google le dit lui-même : sans ce rendu, il est possible qu'il ne voie pas le contenu, parce que beaucoup de sites s'appuient sur JavaScript pour l'afficher (Google Search Central).
Le rendu fonctionne bien sur un site correctement construit. Les problèmes viennent d'ailleurs :
- Le texte enfermé dans une image. C'est le grand classique en Afrique de l'Ouest : l'affiche de l'événement, la grille tarifaire ou la liste des services est publiée en JPG, exactement comme sur Facebook. Pour un humain, c'est lisible. Pour un moteur, c'est une image sans texte, à moins de remplir un texte alternatif, et même alors il n'aura qu'une phrase au lieu de la page entière.
- Le PDF scanné. Un rapport annuel ou un appel d'offres numérisé en photo n'est pas du texte. Google peut lire les PDF, à condition qu'ils contiennent du vrai texte.
- Le contenu qui n'apparaît qu'après un clic sur un onglet chargé à la demande, ou après avoir rempli un formulaire.
Le contrôle à faire : sur votre page, sélectionnez le texte avec la souris. S'il ne se sélectionne pas, c'est une image, et Google ne le lit pas comme du texte. Pour aller plus loin, l'outil d'inspection d'URL de Search Console montre le HTML que Googlebot a réellement reçu.
Étape 3 : l'indexation
L'indexation consiste à comprendre de quoi parle la page : Google analyse le texte, les balises importantes comme le titre, les attributs alt des images, les vidéos. Puis il range le résultat dans son index, une base répartie sur des milliers d'ordinateurs. Selon Google, cet index contient des centaines de milliards de pages et pèse bien plus de 100 millions de gigaoctets (Google, Comment le moteur de recherche Google organise les informations).
Source : Google, « Comment fonctionne la recherche Google », page Organiser l'information (google.com/search/howsearchworks), capture du 19/10/2026.
Pendant cette étape, il se passe deux choses que peu de propriétaires de sites connaissent.
Google choisit une page canonique. Il regroupe les pages au contenu identique ou très proche, puis retient la plus représentative : c'est elle qui pourra s'afficher dans les résultats. Si votre site répond à la fois en http et en https, avec et sans www, ou si la même fiche produit existe sous trois adresses, Google fait un choix à votre place. Le passage à HTTPS bien configuré règle une partie du problème ; nous l'expliquons dans Que signifie HTTPS.
Google collecte des signaux sur la page retenue : sa langue, le pays visé par le contenu, sa facilité d'utilisation. Une page en français claire sur sa ville et son pays a donc plus de chances d'être servie à quelqu'un qui cherche depuis Cotonou.
Et surtout : l'indexation n'est pas garantie. Google le répète noir sur blanc. Toutes les pages explorées ne sont pas indexées, notamment quand le contenu est jugé de faible qualité, quand une balise meta robots interdit l'indexation, ou quand la conception du site rend l'analyse difficile (Google Search Central).
robots.txt et noindex : la confusion qui coûte cher
Beaucoup de gens pensent qu'il suffit de bloquer une page dans le fichier robots.txt pour la faire disparaître de Google. C'est faux. Google précise que le robots.txt sert à gérer le trafic de ses robots, pas à masquer une page : si d'autres sites pointent vers elle, son adresse peut quand même apparaître dans les résultats, sans description (Google, Présentation du fichier robots.txt). Pour qu'une page ne figure pas sur Google, il faut une instruction noindex, une protection par mot de passe, ou la supprimer.
L'erreur inverse est encore plus fréquente : la balise noindex posée pendant le développement pour que le site en chantier ne soit pas indexé, puis oubliée au moment de la mise en ligne. Le site est beau, rapide, et totalement invisible. Sur WordPress, c'est une simple case cochée dans les réglages de lecture. Nous la vérifions systématiquement.
Le contrôle à faire : tapez site:votre-domaine.com dans Google pour voir une partie des pages indexées. Pour une page précise, l'outil d'inspection d'URL de Google Search Console indique si elle est dans l'index et, sinon, pourquoi.
Étape 4 : le classement et l'affichage des résultats
Quand quelqu'un tape une requête, Google ne parcourt pas le Web : il interroge son index et classe les pages correspondantes. Il dit utiliser des centaines de facteurs, dont la position de l'internaute, sa langue et son appareil. Son propre exemple : « atelier de réparation de vélos » ne donne pas les mêmes résultats à Paris et à Hong Kong. Transposez à « imprimerie à Cotonou » ou « cabinet comptable Parakou » : la localisation change tout.
Deux points que nous rappelons souvent à nos interlocuteurs :
- On ne paie pas Google pour être mieux classé dans les résultats naturels. Google écrit qu'il n'accepte aucun paiement pour explorer un site plus souvent ou améliorer son classement, et met en garde contre ceux qui prétendent le contraire. Les annonces payantes existent, mais elles sont signalées comme sponsorisées et relèvent d'un autre système.
- Une page peut être indexée et ne jamais s'afficher. Si son contenu ne correspond pas à ce que les gens cherchent, ou s'il est faible, elle reste dans l'index sans être servie.
La forme des résultats varie aussi selon la requête. Une recherche à intention locale fait apparaître une carte et des fiches d'établissements, qui ne dépendent pas de votre site mais de votre fiche Google. Si c'est ce que vous visez, lisez Créer sa fiche Google Business Profile.
Le contrôle à faire : le rapport Performances de Search Console montre les requêtes sur lesquelles vos pages apparaissent, le nombre d'affichages et de clics. C'est la seule source fiable sur votre visibilité réelle ; les captures d'écran « on est premiers » prises sur votre propre téléphone ne valent pas grand-chose, car vos résultats sont influencés par votre historique et votre position.
Et l'IA, elle change quoi au fonctionnement ?
Les Aperçus IA et le Mode IA de Google rédigent une réponse et l'accompagnent de liens. On pourrait croire qu'il faut désormais une « optimisation IA » spéciale. Google affirme le contraire : aucune exigence supplémentaire, aucune optimisation spéciale. Pour apparaître comme lien dans ces réponses, une page doit simplement être indexée et pouvoir s'afficher avec un extrait. Google précise même qu'il n'est pas nécessaire de créer des fichiers textuels spéciaux pour l'IA ni d'ajouter des données structurées particulières (Google, Fonctionnalités d'IA et votre site Web).
Notre avis est tranché : si quelqu'un vous vend un forfait « référencement IA » alors que votre site n'est même pas correctement indexé, refusez. Les mêmes fondamentaux servent pour les résultats classiques et pour les réponses IA. C'est une bonne nouvelle pour les petites structures : il n'y a pas de deuxième chantier.
Combien de temps avant qu'une nouvelle page apparaisse ?
Il n'existe pas de délai garanti. Google indique que l'exploration peut prendre plusieurs jours, voire plusieurs mois, selon la fréquence à laquelle ses systèmes jugent qu'une page doit être actualisée. Un site neuf, sans aucun lien venant d'ailleurs, sera découvert plus lentement qu'une page ajoutée à un site déjà connu et bien relié.
Ce qui accélère réellement les choses : un lien vers la nouvelle page depuis l'accueil ou une page déjà indexée, un sitemap déclaré dans Search Console, une demande d'indexation via l'inspection d'URL, et quelques liens externes de qualité (annuaire professionnel sérieux, partenaire, média local). Ce qui ne sert à rien : soumettre son site à « 300 moteurs de recherche » pour quelques milliers de francs.
Ce que ça change pour une PME, une ONG ou une institution
Comprendre le mécanisme permet de poser les bonnes questions à votre prestataire, ou à vous-même. Voici la grille que nous appliquons, étape par étape :
- Exploration : le site est-il en ligne de façon stable ? Le robots.txt laisse-t-il passer Googlebot ? Chaque page importante reçoit-elle au moins un lien interne ?
- Rendu : les informations clés (services, horaires, adresse, prix ou mode de devis, contacts) sont-elles écrites en texte, et pas seulement dans des images ? Le site s'affiche-t-il complètement sur un téléphone d'entrée de gamme ?
- Indexation : une seule version du site (https, avec ou sans www, pas les deux) ? Aucune balise noindex oubliée ? Chaque page a-t-elle un titre unique et un contenu qui lui est propre ?
- Classement : les pages répondent-elles à des questions que vos clients, donateurs ou usagers se posent vraiment, avec les mots qu'ils emploient ? Votre ville et votre pays sont-ils clairement mentionnés ?
- Mesure : Search Console est-elle ouverte, et quelqu'un la regarde-t-il au moins une fois par mois ?
Une ONG qui publie ses rapports d'activité en PDF scanné, une mairie dont les avis sont des photos d'affiches, une PME dont le catalogue n'existe que sur Facebook : dans les trois cas, l'information existe, mais le moteur ne peut pas la lire. Aucune technique avancée ne compensera ça. Un blog d'entreprise régulier, en revanche, donne à Google une raison de revenir explorer le site ; nous expliquons comment le tenir dans Comment créer un blog d'entreprise.
Les idées reçues sur les moteurs de recherche
- « Une page Facebook suffit pour être sur Google. » Google peut afficher votre page Facebook, mais vous ne contrôlez ni son contenu ni sa structure, et elle ne remplace pas un site que vous possédez.
- « Plus il y a de pages, mieux c'est. » Des dizaines de pages vides ou copiées les unes sur les autres finissent regroupées ou ignorées à l'indexation. Mieux vaut dix pages utiles.
- « Le robots.txt protège mes documents. » Non. Il ne s'impose qu'aux robots qui veulent bien le respecter, et il ne retire pas une adresse des résultats. Un document confidentiel se protège par mot de passe.
- « Être indexé, c'est être premier. » L'indexation vous fait entrer dans la bibliothèque. Le classement décide si quelqu'un vous trouve sur l'étagère.
Pour la suite, une fois le mécanisme compris, la méthode pour être visible est détaillée dans Comment apparaître sur Google, et les raisons pour lesquelles un site visible peut quand même ne rien rapporter dans Pourquoi votre site web ne vous rapporte rien.
À lire aussi : Référencement local et Mots-clés SEO.
Questions fréquentes sur les moteurs de recherche
Qu'est-ce qu'un moteur de recherche, en une phrase ?
Un service qui explore le Web avec des robots, range les pages dans un index, puis vous montre les plus pertinentes quand vous tapez une requête.
Quel est le moteur de recherche le plus utilisé au Bénin ?
Google, avec 95,11 % des recherches en septembre 2026 selon StatCounter, loin devant Bing (4,16 %).
Quelle est la différence entre exploration et indexation ?
L'exploration, c'est la visite de la page par le robot. L'indexation, c'est l'analyse et le rangement de son contenu dans la base du moteur. Une page peut être explorée sans être indexée.
Google est-il un navigateur ?
Non. Google est un moteur de recherche. Le navigateur de Google s'appelle Chrome. On peut utiliser Google dans Firefox, et un autre moteur dans Chrome.
Comment savoir si mon site est indexé par Google ?
Tapez site:votre-domaine.com dans Google pour une première idée, puis utilisez l'inspection d'URL dans Google Search Console, gratuite, pour une réponse page par page.
Peut-on payer Google pour être indexé plus vite ?
Non. Google n'accepte aucun paiement pour l'exploration, l'indexation ou le classement dans les résultats naturels. Seules les annonces sont payantes, et elles sont signalées comme telles.
Les moteurs de recherche IA vont-ils remplacer Google ?
Ils prennent une place réelle pour les questions complexes, mais Google intègre déjà l'IA à ses résultats et s'appuie sur le même index. Pour un site, la priorité reste d'être exploré, lisible et indexé : c'est la condition pour être cité, par un moteur classique comme par une IA.
Votre site est en ligne mais introuvable ?
Chez Guelichweb, nous accompagnons les PME, les ONG et les institutions au Bénin et en Afrique francophone : création de sites pensés pour être lus par les moteurs, diagnostic d'indexation, Search Console, et automatisations qui font gagner du temps à l'équipe. Le prix dépend de votre situation : nous établissons un devis après diagnostic, comme expliqué sur notre page offres. Découvrez nos services et notre offre de création de site web à Cotonou, ou contactez-nous pour que nous regardions où votre site bloque.